
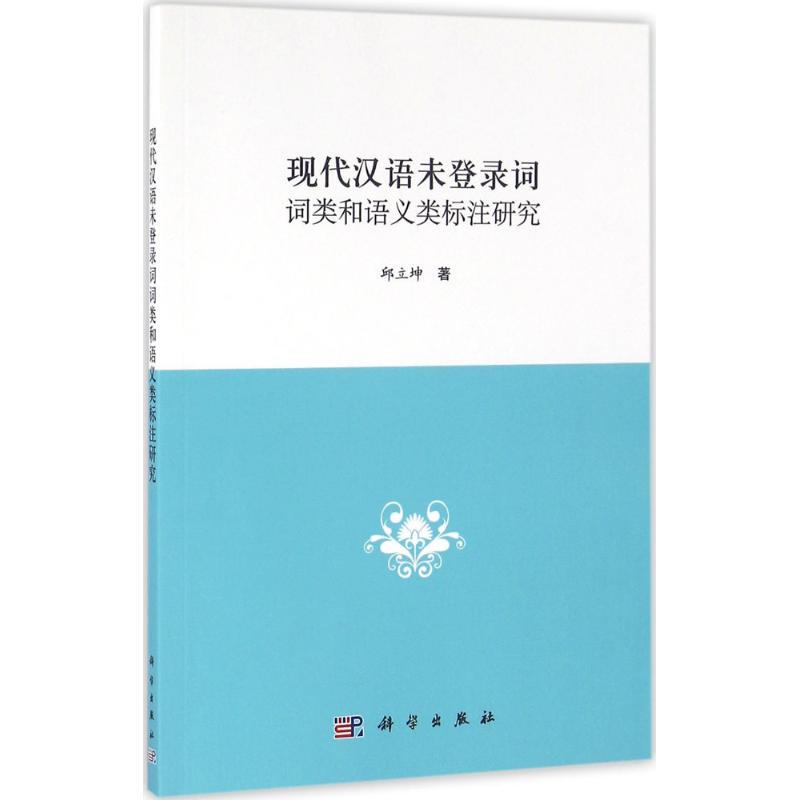
内容简介

未登录词处理主要包括识别、词类标注和语义类标注等内容。目前自然语言处理学界对于未登录词识别研究较多,对于未登录词词类标注和语义类标注则研究较少。因此,本文主要专注于现代汉语未登录词词类标注和语义类标注的研究。在未登录词词类标注和语义类标注过程中主要有两类可以使用的特征,即内部特征和外部特征。所谓内部特征指未登录词的成分、成分的属性以及成分、成分属性的组合序列;所谓外部特征指未登录词在语料中的分布,通常用未登录词的上下文来表示。本文在前人研究工作的基础上,构建了大规模的生语料库,分别使用基于内部特征和外部特征的方法以及两种特征相结合的方法来自动处理未登录词词类和语义类标注的问题。











评论晒单