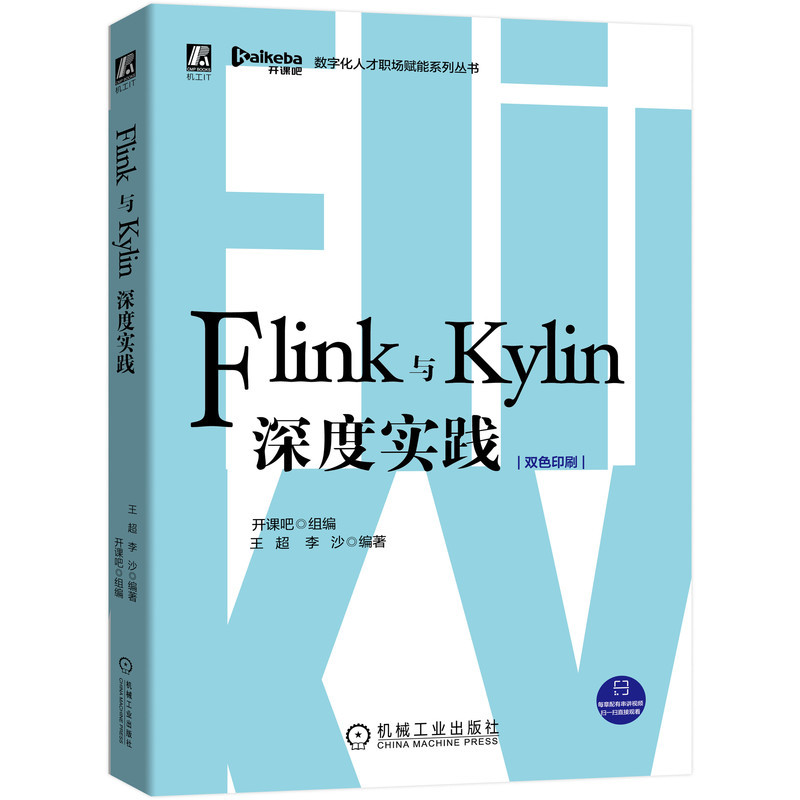
Flink与Kylin深度实践(双色印刷)/数字化人才职场赋
作 者: 开课吧 组编 王超 李沙 编 著

定 价: 69.9
出 版 社: 机械工业出版社
出版日期: 2020年08月01日
页 数: 241
装 帧: 平装
ISBN: 9787111660170

●致数字化人才的一封信前言●章Flink及其运行模式简介1.1Flink介绍1.2Flink的特性1.3功能模块1.4编程模型1.5重新编译1.6任务提交模型1.7部署运行模式1.8本章小结●第2章Flink的部署安装及入门案例2.1local模式部署安装2.2standalone模式部署安装2.3standalone模式的HA环境2.4standalone模式在HA环境下提交任务2.5Flink on YARN模式2.5.1单个YARN Session模式2.5.2多个YARN Session模式2.5.3“flink run”脚本分析2.6入门案例2.6.1实时处理程序实现2.6.2离线批量处理程序实现2.7shell命令行代码调试2.7.1批量处理代码调试2.7.2实时处理代码调试2.8本章小结●第3章Flink实时处理之DataStream3.1DataStream的数据源3.1.1Socket数据源3.1.2文件数据源3.1.3从集合中获取数据3.1.4自定义数据源3.2DataStream常用算子3.2.1transformation算子3.2.2partition算子3.2.3sink算子3.3窗口和时间3.3.1窗口的类型3.3.2窗口的应用3.3.3窗口数值聚合统计3.3.4时间的类型3.4用watermark解决乱序与数据延迟问题3.4.1watermark的作用3.4.2watermark解决数据延时问题3.4.3watermark如何生成3.4.4watermark处理乱序数据3.4.5比watermark更晚的数据如何解决3.4.6多并行度的watermark机制3.5DataStream的状态保存和恢复3.5.1keyed state的托管状态3.5.2operator state的托管状态3.5.3状态管理之StateBackend3.5.4用checkpoint保存数据3.5.5用savepoint保存数据3.6DataStream集成Kafka3.6.1导入jar包3.6.2将Kafka作为Flink的source3.6.3将Kafka作为Flink的sink3.7本章小结●第4章Flink批量处理之DataSet4.1DataSet的内置数据源4.1.1文件数据源4.1.2集合数据源4.2DataSet常用算子4.2.1transformation算子4.2.2partition算子4.2.3sink算子4.3DataSet的参数传递4.4DataSet连接器4.4.1文件系统连接器4.4.2Flink集成HBase之数据读取4.4.3Flink读取数据写入HBase4.5广播变量、累加器与分布式缓存4.5.1广播变量4.5.2累加器4.5.3分布式缓存4.6本章小结●第5章Flink的Table与SQL5.1Table与SQL简介5.2为什么需要SQL5.3Table与SQL的语法解析5.3.1创建TableEnvironment对象5.3.2注册表5.3.3查询表5.3.4注册数据保存表5.3.5Table与SQL的数据查询执行原理5.3.6DataStream与DataSet集成5.4Table与SQL编程开发5.4.1使用SQL读取CSV文件并进行查询5.4.2DataStream与表的互相转换5.4.3DataSet与表的互相转换5.4.4SQL处理Kafka的JSON格式数据5.5本章小结●第6章Flink数据去重与数据连接6.1数据去重6.1.1基于MapState实现流式去重6.1.2基于SQL实现流式去重6.2流的连接实现6.2.1使用CoGroup实现流连接6.2.2interval join机制6.2.3SQL实现连接操作6.3本章小结●第7章Flink中的复杂事件处理(CEP)机制7.1CEP简介7.2CEP中的模式7.2.1个体模式(Individual Pattern)7.2.2组合模式(Combining Pattern)7.2.3模式组(Group of Patterns)7.3CEP综合案例7.3.1用户IP变换报警7.3.2高温预警7.3.3支付超时监控7.4本章小结●第8章Flink调优与监控8.1监控指标8.1.1系统监控指标8.1.2自定义监控指标8.2反压机制与监控8.2.1反压线程采样8.2.2反压线程配置8.3checkpoint监控8.4checkpoint调优8.4.1如何衡量checkpoint的速度大小8.4.2相邻checkpoint的间隔时间设置8.4.3checkpoint资源设置8.4.4checkpoint的Task本地性恢复8.4.5异步checkpoint设置8.4.6checkpoint数据压缩8.5内存管理调优8.5.1内存托管8.5.2内存段管理8.5.3内存段与字节缓冲区8.5.4内存段对垃圾收集器的影响8.5.5内存配置8.5.6堆外内存8.6本章小结●第9章基于Flink实现实时数据同步解析9.1实时数仓架构9.2MySQL数据实时同步9.2.1MySQL的binlog介绍9.2.2maxwell简介9.2.3开启MySQL的binlog功能9.2.4安装maxwell实现实时采集MySQL数据9.2.5启动服务9.2.6插入数据并进行测试9.3数据库建表9.4开发模拟数据生成模块9.4.1创建Maven工程并导入jar包9.4.2开发Flink程序批量导入商品表数据9.4.3开发订单生成程序模拟订单持续生成9.5数据获取模块开发9.5.1全量拉取数据9.5.2增量拉取数据9.6本章小结●0章基于Kylin的实时数据统计10.1Kylin简介10.1.1为什么要使用Kylin10.1.2Kylin的使用场景10.1.3Kylin如何解决海量数据的查询问题10.2Kylin基础知识10.2.1数据仓库、OLAP、BI10.2.2事实表与维度表10.2.3维度与度量10.2.4数据仓库常用建模方式10.2.5数据立方体10.2.6Kylin的工作原理10.2.7Kylin的体系架构10.2.8Kylin的特点10.3Kylin环境搭建10.3.1单机模式安装10.3.2集群环境搭建10.4Kylin的使用10.4.1创建Hive数据10.4.2创建Kylin工程10.4.3为Kylin添加模型10.4.4通过Kylin来构建Cube10.4.5构建Cube10.4.6数据查询分析10.5K

内容简介

本书从实用角度出发,首先介绍了Flink的功能模块、运行模式、部署安装等内容,然后着重介绍了Flink中的实时处理技术和批量处理技术,接着讲解了Flink的Table与SQL、CEP机制、调优与监控、实时数据同步解析,*后通过Flink结合Kylin实现了实时数据统计的功能。本书内容全面,由浅入深,包含大量的代码示例,并提供服务,每章配有重要知识点串讲视频和小结,以指导读者轻松入门。本书适合有一定编程及大数据开发经验,有数据实时处理工作需求或者想要从事相关工作的读者阅读。







评论晒单