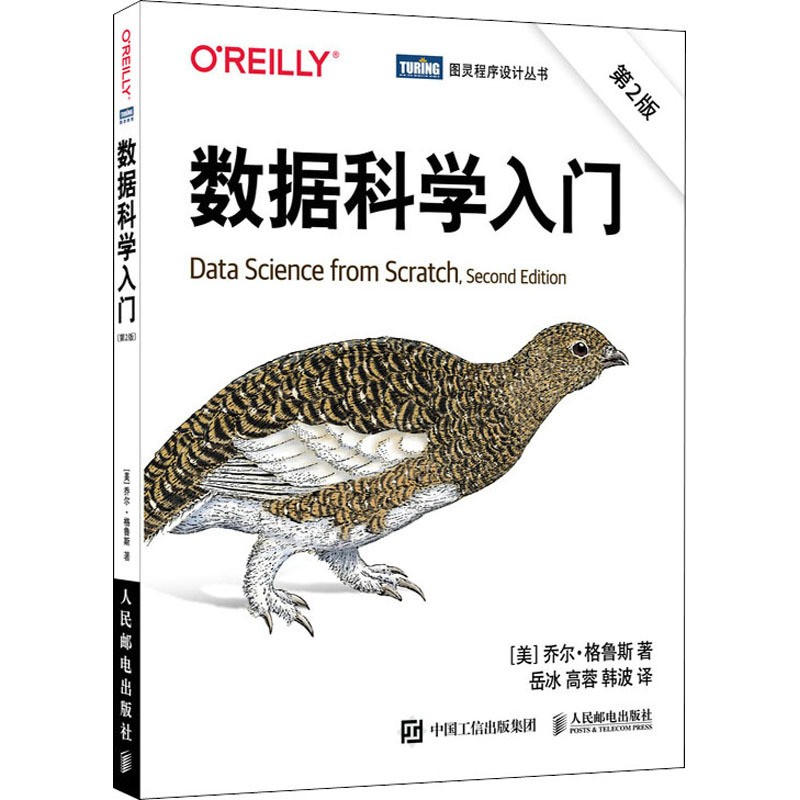
数据科学入门 第2版
作 者: (美)乔尔·格鲁斯 著 岳冰,高蓉,韩波 译

定 价: 109
出 版 社: 人民邮电出版社
出版日期: 2021年01月01日
页 数: 356
装 帧: 平装
ISBN: 9787115552761

●第2版前言xiii
版前言xvii
章导论1
1.1数据的崛起1
1.2什么是数据科学1
1.3激励假设:DataSciencester2
1.3.1寻找关键联系人3
1.3.2你可能知道的数据科学家5
1.3.3工资和工作年限8
1.3.4付费账户10
1.3.5感兴趣的主题10
1.3.6展望12
第2章Python速成13
2.1Python之禅13
2.2获取Python14
2.3虚拟环境14
2.4空白格式15
2.5模块16
2.6函数17
2.7字符串18
2.8异常19
2.9列表19
2.10元组21
2.11字典22
2.12计数器24
2.13集24
2.14控制流25
2.15真和假26
2.16排序27
2.17列表解析27
2.18自动化测试和断言28
2.19面向对象编程29
2.20迭代器和生成器31
2.21随机性32
2.22正则表达式33
2.23函数式编程34
2.24压缩和参数拆分34
2.25args和kwargs35
2.26类型注释36
2.27欢迎来到DataSciencester39
2.28进一步探索39
第3章数据可视化40
3.1matplotlib40
3.2条形图42
3.3线图45
3.4散点图46
3.5延伸学习48
第4章线性代数49
4.1向量49
4.2矩阵53
4.3延伸学习56
第5章统计学57
5.1描述单个数据集57
5.1.1中心倾向59
5.1.2离散度61
5.2相关62
5.3辛普森悖论64
5.4相关系数的其他注意事项65
5.5相关与因果66
5.6延伸学习66
第6章概率68
6.1依赖和独立68
6.2条件概率69
6.3贝叶斯定理71
6.4随机变量72
6.5连续分布72
6.6正态分布73
6.7中心极限定理76
6.8延伸学习78
第7章假设和推论79
7.1统计假设检验79
7.2实例:掷硬币79
7.3p值82
7.4置信区间84
7.5p-Hacking84
7.6实例:运行A/B测试85
7.7贝叶斯推断86
7.8延伸学习89
第8章梯度下降90
8.1梯度下降的思想90
8.2估算梯度91
8.3使用梯度94
8.4选择正确步长94
8.5使用梯度下降拟合模型95
8.6小批次梯度下降和随机梯度下降96
8.7延伸学习98
第9章获取数据99
9.1stdin和stdout99
9.2读取文件101
9.2.1文本文件的基础101
9.2.2限制的文件102
9.3网络抓取104
9.4使用API106
9.4.1JSON和XML106
9.4.2使用无验证的API107
9.4.3寻找API108
9.5实例:使用TwitterAPI109
9.6延伸学习112
0章数据工作113
10.1探索数据113
10.1.1探索一维数据113
10.1.2两个维度115
10.1.3多维数据116
10.2使用NamedTuple18
10.3数据类119
10.4清洗和修改120
10.5数据处理122
10.6数据调整25
10.7题外话:tqdm126
10.8降维127
10.9延伸学习133
1章机器学习134
11.1建模134
11.2什么是机器学习135
11.3过拟合与欠拟合135
11.4正确性138
11.5偏差-方差权衡140
11.6特征提取与选择141
11.7延伸学习142
2章k最近邻法143
12.1模型143
12.2实例:鸢尾花数据集145
12.3维数灾难148
12.4进一步探索152
3章朴素贝叶斯算法153
13.1一个简易的垃圾邮件过滤器153
13.2一个复杂的垃圾邮件过滤器154
13.3算法实现155
13.4测试模型157
13.5使用模型158
13.6延伸学习161
4章简单线性回归162
14.1模型162
14.2使用梯度下降法165
14.3优选似然估计166
14.4延伸学习166
5章多元回归167
15.1模型167
15.2最小二乘模型的进一步假设168
15.3拟合模型169
15.4解释模型171
15.5拟合优度171
15.6题外话:Bootstrap172
15.7回归系数的标准误差173
15.8正则化175
15.9延伸学习177
6章逻辑回归178
16.1问题178
16.2logistic函数180
16.3应用模型183
16.4拟合优度184
16.5支持向量机185
16.6延伸学习188
7章决策树89
17.1什么是决策树189
17.2熵191
17.3分割的熵193
17.4创建决策树194
17.5综合运用196
17.6随机森林199
17.7延伸学习199
8章神经网络200
18.1感知器200
18.2前馈神经网络202
18.3反向传播205
18.4实例:FizzBuzz207
18.5延伸学习210
9章深度学习211
19.1张量211
19.2层抽象213
19.3线性层215
19.4把神经网络作为层序列218
19.5损失函数与优化器219
19.6实例:重新设计异或网络221
19.7其他激活函数222
19.8实例:重新解决FizzBuzz问题223
19.9softmax函数和交叉熵224
19.10丢弃227
19.11实例:MNIST227
19.12保存和加载模型231
19.13延伸学习232
第20章聚类分析233
20.1原理233
20.2模型234
20.3实例:聚会236
20.4选择聚类数目k238
20.5实例:色彩聚类239
20.6自下而上的分层聚类241
20.7延伸学习246
第21章自然语言处理247
21.1词云247
21.2n-gram语言模型249
21.3语法252
21.4题外话:吉布斯采样254
21.5主题建模255
21.6词向量260
21.7递归神经网络268
21.8实例:使用字符级RNN271
21.9延伸学习274
第22章网络分析275
22.1中介中心性275
22.2特征向量中心性280
22.2.1矩阵乘法280
22.2.2中心性282
22.3有向图与PageRank283
22.4延伸学习286
第23章推荐系统287
23.1人工管理288
23.2推荐流行事务288
23.3基于用户的协同过滤289
23.4基于项目的协同过滤292
23.5矩阵分解294
23.6延伸学习298
第24章数据库与SQL299
24.1CREATETABLE与INSERT299
24.2UPDATE302
24.3DELETE303
24.4SELECT304
24.5GROUPBY306
24.6ORDERBY308
24.7JOIN309
24.8子查询311
24.9索引312
24.10查询优化312
24.11NoSQL313
24.12延伸学习313
第25章MapReduce314
25.1实例:单词计数315
25.2为什么是MapReduce316
25.3更一般化的MapReduce317
25.4实例:状态分析更新318
25.5实例:矩阵乘法320
25.6题外话:组合器321
25.7延伸学习322
第26章数据伦理323
26.1什么是数据伦理323
26.2讲真的,什么是数据伦理324
26.3是否应该关注数据伦理324
26.4建立不良数据产品325
26.5精确与公平之间的较量325
26.6合作327
26.7可解释性327
26.8推荐327
26.9异常数据328
26.10数据保护329
26.11小结329
26.12延伸学习329
第27章数据科学前瞻330
27.1IPython330
27.2数学331
27.3不从零开始331
27.3.1NumPy331
27.3.2pandas331
27.3.3scikit-learn331
27.3.4可视化332
27.3.5R332
27.3.6深度学习332
27.4寻找数据333
27.5从事数据科学工作333
27.5.1HackerNews333
27.5.2消防车333
27.5.3T恤334
27.5.4地球仪上的推文334
27.5.5你的发现335
关于作者336
关于封面336

内容简介

本书基于Python语言环境,从零开始讲解数据科学工作,讲述数据科学工作所需的技能与诀窍,并带领读者熟悉数据科学的核心知识:数学与统计学。作者借助大量具有现实意义的实例详细展示了什么是数据科学,介绍了从事数据科学工作需要用到的库,如NumPy、scikit-learn、pandas等,还在每章末尾推荐了很多学习资源,帮助你进一步巩固本书所学。新版基于Python 3.6,重写了所有示例和代码,并根据数据科学近几年的发展,新增了关于深度学习、统计学和自然语言处理等主题,让图书内容与时俱进。








评论晒单