
| 产品展示 |
| 基本信息 |
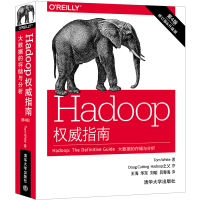
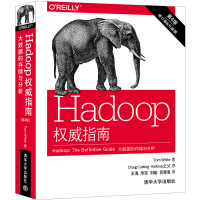
图书名称: | Hadoop权威指南:大数据的存储与分析(第4版) |
作者: | [美]Tom White |
定价: | 148.00 |
ISBN号: | 9787302465133 |
出版社: | 清华大学出版社 |
开本: | 16开 |
装帧: | 平装 |
| 编辑推荐 |
| 内容介绍 |
| 本书结合理论和实践,由浅入深,QFW介绍了Hadoop这一高性能的海量数据处理和分析平台。全书5部分24章,第Ⅰ部分介绍Hadoop基础知识,主题涉及Hadoop、MapReduce、Hadoop分布式文件系统、YARN、Hadoop的I/O操作。第Ⅱ部分介绍MapReduce,主题包括MapReduce应用开发;MapReduce的工作机制、MapReduce的类型与格式、MapReduce的特性。第Ⅲ部分介绍Hadoop的运维,主题涉及构建Hadoop集群、管理Hadoop。第Ⅳ部分介绍Hadoop相关开源项目,主题涉及Avro、Parquet、Flume、Sqoop、Pig、Hive、Crunch、Spark、HBase、ZooKeeper。第Ⅴ部分提供了三个案例,分别来自医疗卫生信息技术服务商塞纳(Cerner)、微软的人工智能项目ADAM(一种大规模分布式深度学习框架)和开源项目Cascading(一个新的针对MapReduce的数据处理API)。本书是一本权威、QM的Hadoop参考书和工具书,阐述了Hadoop生态圈的ZX发展和应用,程序员可以从中探索海量数据集的存储和分析,管理员可以从中了解Hadoop集群的安装和运维。 |
| 作者介绍 |
| 作者简介Tom White是最杰出的Hadoop专家之一。自2007年2月以来,Tom White一直是Apache Hadoop的提交者(committer),也是Apache软件基金会的成员。Tom是Cloudera的软件工程师,他是Cloudera的首批员工,对Apache和Cloudera做出了举足轻重的贡献。在此之前,他是一名独立的Hadoop顾问,帮助公司搭建、使用和扩展Hadoop。他是很多行业大会的专题演讲人,比如ApacheCon、OSCON和Strata。Tom在英国剑桥大学获得数学学士学位,在利兹大学获得科学哲学硕士学位。他目前与家人居住在威尔士。译者简介王海博士,解放军理工大学通信工程学院教授,博导,教研中心主任,长期从事无线自组网网络的设计与研发工作,主持国家自然科学基金、国家863计划课题等多项GJJ课题,近5年获军队科技进步二等奖1项,三等奖6项,作为DY发明人申请国家发明专利十余项,发表学术论文50余篇。 华东博士,现任南京医科大学计算机教研室教师,一直致力于计算机辅助教学的相关技术研究,陆续开发了人体解剖学网络自主学习考试平台、诊断学自主学习平台和面向执业医师考试的预约化考试平台等系统,并在各个学科得到广泛的使用,获得全国高等学校计算机课件评比一等奖和三等奖各一项。主编、副主编教材两部,获发明专利一项、软件著作权多项。 刘喻博士,长期从事软件开发、软件测试和软件工程化管理工作,目前任教于清华大学软件所。 吕粤海,长期从事军事通信网络技术研究与软件开发工作,先后通过华为光网络高级工程师认证、思科网络工程师认证。 |
| 目录 |
| 目录 第Ⅰ部分 Hadoop基础知识 第1章 初识Hadoop 3 1.1 数据!数据! 3 1.2 数据的存储与分析 5 1.3 查询所有数据 6 1.4 不仅仅是批处理 7 1.5 相较于其他系统的优势 8 1.6 Apache Hadoop发展简史 12 1.7 本书包含的内容 16 第2章 关于MapReduce 19 2.1 气象数据集 19 2.2 使用Unix工具来分析数据 21 2.3 使用Hadoop来分析数据 22 2.4 横向扩展 31 2.5 Hadoop Streaming 37 第3章 Hadoop分布式文件系统 42 3.1 HDFS的设计 42 3.2 HDFS的概念 44 3.3 命令行接口 50 3.4 Hadoop文件系统 52 3.5 Java接口 56 3.6 数据流 68 3.7 通过distcp并行复制 76 第4章 关于YARN 78 4.1 剖析YARN应用运行机制 79 4.2 YARN与MapReduce 1相比 82 4.3 YARN中的调度 85 4.4 延伸阅读 95 第5章 Hadoop的I/O操作 96 5.1 数据完整性 96 5.2 压缩 99 5.3 序列化 109 5.4 基于文件的数据结构 127 第Ⅱ部分 关于MapReduce 第6章 MapReduce应用开发 141 6.1 用于配置的API 142 6.2 配置开发环境 144 6.3 用MRUnit来写单元测试 152 6.4 本地运行测试数据 156 6.5 在集群上运行 160 6.6 作业调优 174 6.7 MapReduce的工作流 176 第7章 MapReduce的工作机制 184 7.1 剖析MapReduce作业运行机制 184 7.2 失败 191 7.3 shuffle和排序 195 7.4 任务的执行 201 第8章 MapReduce的类型与格式 207 8.1 MapReduce的类型 207 8.2 输入格式 218 8.3 输出格式 236 第9章 MapReduce的特性 243 9.1 计数器 243 9.2 排序 252 9.3 连接 264 9.4 边数据分布 270 9.5 MapReduce库类 276 第Ⅲ部分 Hadoop的操作 第10章 构建Hadoop集群 279 10.1 集群规范 280 10.2 集群的构建和安装 284 10.3 Hadoop配置 288 10.4 AQ性 305 10.5 利用基准评测程序测试 Hadoop集群 311 第11章 管理Hadoop 314 11.1 HDFS 314 11.2 监控 327 11.3 维护 329 第Ⅳ部分 Hadoop相关开源项目 第12章 关于Avro 341 12.1 Avro数据类型和模式 342 12.2 内存中的序列化和反序列化特定API 347 12.3 Avro数据文件 349 12.4 互操作性 351 12.5 模式解析 352 12.6 排列顺序 354 12.7 关于Avro MapReduce 356 12.8 使用Avro MapReduce 进行排序 359 12.9 其他语言的Avro 362 第13章 关于Parquet 363 13.1 数据模型 364 13.2 Parquet文件格式 367 13.3 Parquet的配置 368 13.4 Parquet文件的读/写 369 13.5 Parquet MapReduce 374 第14章 关于Flume 377 14.1 安装Flume 378 14.2 示例 378 14.3 事务和可靠性 380 14.4 HDFS Sink 382 14.5 扇出 385 14.6 通过代理层分发 387 14.7 Sink组 391 14.8 Flume与应用程序的集成 395 14.9 组件编目 395 14.10 延伸阅读 397 第15章 关于Sqoop 398 15.1 获取Sqoop 398 15.2 Sqoop连接器 400 15.3 一个导入的例子 401 15.4 生成代码 404 15.5 深入了解数据库导入 405 15.6 使用导入的数据 409 15.7 导入大对象 412 15.8 执行导出 414 15.9 深入了解导出功能 416 15.10 延伸阅读 419 第16章 关于Pig 420 16.1 安装与运行Pig 421 16.2 示例 425 16.3 与数据库进行比较 428 16.4 PigLatin 429 16.5 用户自定义函数 446 16.6 数据处理操作 455 16.7 Pig实战 465 16.8 延伸阅读 468 第17章 关于Hive 469 17.1 安装Hive 470 17.2 示例 472 17.3 运行Hive 473 17.4 Hive与传统数据库相比 480 17.5 HiveQL 483 17.6 表 488 17.7 查询数据 501 17.8 用户定义函数 508 17.9 延伸阅读 516 第18章 关于Crunch 517 18.1 示例 518 18.2 Crunch核心API 521 18.3 管线执行 537 18.4 Crunch库 545 18.5 延伸阅读 547 第19章 关于Spark 548 19.1 安装Spark 549 19.2 示例 549 19.3 弹性分布式数据集 555 19.4 共享变量 564 19.5 剖析Spark作业运行机制 565 19.6 执行器和集群管理器 570 19.7 延伸阅读 574 第20章 关于HBase 575 20.1 HBase基础 575 20.2 概念 576 20.3 安装 581 20.4 客户端 584 20.5 创建在线查询应用 589 20.6 HBase和RDBMS的比较 598 20.7 Praxis 601 20.8 延伸阅读 602 第21章 关于ZooKeeper 604 21.1 安装和运行ZooKeeper 605 21.2 示例 607 21.3 ZooKeeper服务 615 21.4 使用ZooKeeper来构建应用 629 21.5 生产环境中的ZooKeeper 640 21.6 延伸阅读 643 第Ⅴ部分 案例学习 第22章 医疗公司塞纳(Cerner) 的可聚合数据 647 22.1 从多CPU到语义集成 647 22.2 进入Apache Crunch 648 22.3 建立全貌 649 22.4 集成健康医疗数据 651 22.5 框架之上的可组合性 654 22.6 下一步 655 第23章 生物数据科学:用软件拯救生命 657 23.1 DNA的结构 659 23.2 遗传密码:将DNA字符转译为蛋白质 660 22.3 将DNA想象成源代码 661 23.4 人类基因组计划和参考基因组 663 22.5 DNA测序和比对 664 23.6 ADAM,一个可扩展的基因组分析平台 666 23.7 使用Avro接口描述语言进行自然语言编程 666 23.8 使用Parquet进行面向列的存取 668 23.9 一个简单例子:用Spark和 ADAM做k-mer计数 669 23.10 从个性化广告到个性化医疗 672 23.11 联系我们 673 第24章 开源项目Cascading 674 24.1 字段、元组和管道 675 24.2 操作 678 24.3 Taps,Schemes和Flows 680 24.4 Cascading实践应用 681 24.5 灵活性 684 24.6 ShareThis中的Hadoop和 Cascading 685 24.7 总结 689 附录A 安装Apache Hadoop 691 附录B 关于CDH 697 附录C 准备NCDC气象数据 699 附录D 新版和旧版Java MapReduce API 702 |
 |
 |









评论晒单